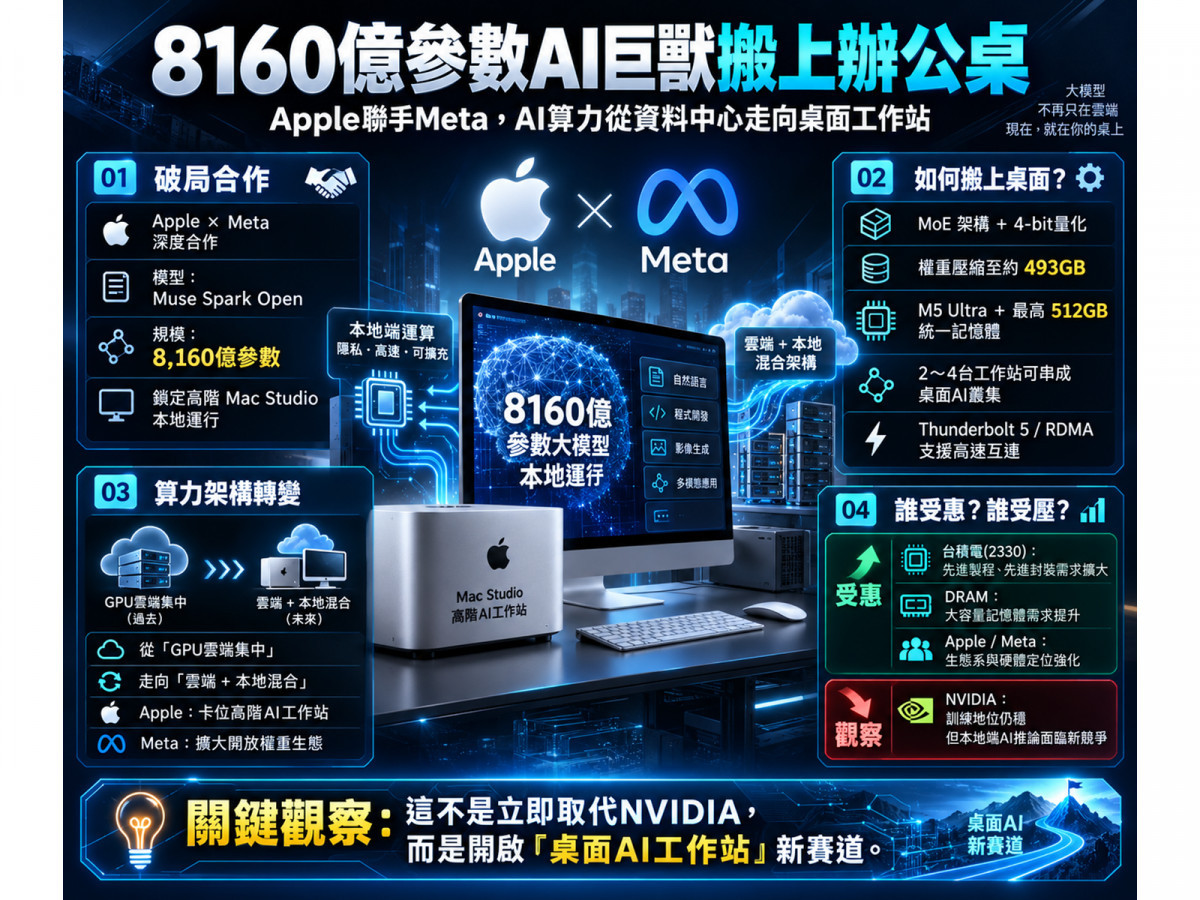
AI算力市場正出現一條與大型雲端GPU資料中心平行的新路線。
Meta於2026年10月15日正式發布號稱「目前最強大的美國開放權重模型」Muse Spark Open,並宣布與Apple展開深度合作,針對搭載M5 Ultra晶片的Mac Studio及Apple自研MLX框架進行底層優化,讓高達8,160億參數的AI模型能直接在辦公室桌面運行。
這場由Apple新任執行長John Ternus與Meta執行長Mark Zuckerberg公開互動背書的合作,據Meta首席AI官Alexandr Wang(汪滔)透露已密謀數月,象徵兩大科技巨頭因AI共同利益重新聯手。
不過,投資人首先必須釐清兩大市場誤區:第一,這次合作並非將Meta模型內建於macOS、Siri或Apple Intelligence,也不是Apple獨占,而是開發者可自行下載權重並在Mac Studio上透過MLX執行(該模型同樣支援NVIDIA、AMD、Intel與各大雲端API平台);
第二,Meta於10月12日推出的Muse Wonder與Muse Wonder Full才是挑戰OpenAI與Anthropic的最高階旗艦模型,Muse Spark Open的真正突破在於「兼具高能力與開放權重,可下載、修改與私有部署」。
這起事件的核心意義在於AI算力正從「GPU雲端集中化」走向「雲端+本地混合架構」,而Apple也首次確立了將Mac打造成「高階AI工作站」的硬體定位。
8160億參數模型如何搬上桌面?統一記憶體與Thunderbolt 5打破VRAM極限
過去超大型語言模型(LLM)難以在個人電腦運行,核心瓶頸往往不是GPU算力不足,而是傳統高階PC採「CPU RAM+獨立GPU VRAM」分離架構(GPU通常僅32GB至96GB VRAM),根本裝不下龐大的模型權重。
Muse Spark Open具備8,160億個總參數、100萬Token上下文視窗與原生多模態能力,專攻程式編寫、AI Agent與複雜多步驟推理。
為將這頭巨獸搬上辦公桌,Apple與Meta動用了三大軟硬體架構創新:
- MoE架構與4-bit量化大幅壓縮容量:
Muse Spark Open採用專家混合(Mixture-of-Experts)架構,每次推論僅啟動約420億個參數(Active Parameters)。透過NVFP4(4-bit量化)技術,模型本身的記憶體占用從原生BF16的超過1.6TB大幅壓縮至約493GB。 - M5 Ultra與512GB統一記憶體(Unified Memory):
新一代M5 Ultra首度採用四晶粒架構(由兩個雙晶粒M5 Max透過超過4.4TB/s的UltraFusion互連整合),配備最高36核心CPU、80核心GPU(每個GPU核心皆加入Neural Accelerator),並提供最高512GB統一記憶體與1.2TB/s記憶體頻寬,讓GPU能直接共享整個超大記憶體池。 - RDMA over Thunderbolt 5 串聯桌面AI叢集:
由於493GB僅為模型權重,推論時還需加上KV Cache、中間激活值(Intermediate Activations)與系統開銷,單台512GB的Mac Studio仍無法獨立運行。
Apple為此在macOS 26.2中加入低延遲的Thunderbolt RDMA驅動程式,利用MLX框架將2至4台Mac Studio透過管線平行(Pipeline Parallelism)或張量平行(Tensor Parallelism)組成小型運算叢集(甚至以雙Thunderbolt線連接單一對主機提升頻寬)。
實測顯示,4台M5 Ultra Mac Studio組成的叢集,生成速度已可超過每秒36個Tokens。
Apple與Meta打什麼算盤?拆解兩大巨頭的AI戰略與3大風險
截至10月15日美股收盤,Apple微跌0.28%收342美元,Meta微跌0.11%收736.72美元,反映市場並未將此合作視為短期暴增營收的題材,而是中長期的產業結構轉折。
1. Apple:不硬拚最大模型,靠「高容量記憶體」拉升Mac客單價
Apple在AI競賽中採取「模型中立策略(Model-Agnostic Strategy)」,除了今年6月宣布與Google合作、利用Gemini家族技術打造下一代Apple基礎模型(Private Cloud Compute亦與Google Cloud及NVIDIA基礎設施合作)外,硬體端則聚焦讓全球最強模型都能在Apple硬體上高效運行。
這項策略直接將記憶體容量轉化為硬體毛利動能:M5 Ultra Mac Studio起價為5,499美元,256GB高階版本媒體實測售價約10,799美元(512GB版本預計10月底上市)。當AI開發團隊、量化金融機構與企業實驗室為運行本地端模型而採購10,000美元以上的高階機種、甚至一次採購2至4台時,將顯著優化Mac產品組合並推升平均售價。
2. Meta:以開放權重收編開發者,讓千億資本支出看見變現路徑
對Meta而言,與Apple合作具備四大戰略利益:
第一,直接觸及習慣使用Mac的龐大軟體工程師群體,擴大Muse開發者生態;
第二,延續開放權重策略,削弱OpenAI、Anthropic與Google的封閉API生態;
第三,抗衡Qwen、DeepSeek、Mistral等中歐開放權重模型的影響力;
第四,將「Muse模型 → Muse Agent → API/訂閱制 → 社群平台與智慧眼鏡 → 廣告AI」串成完整商業鏈,向市場證明龐大的AI資本支出正轉化為可見成果。
然而,本地端AI(Local AI)雖然解決了企業最在意的「資料隱私(原始碼、金融與醫療機密不外流)」、「API成本(從按Token計費的OPEX轉為硬體CAPEX)」與「離線運作」三大痛點,目前仍面臨三大現實門檻:
- 高昂硬體成本:
組建2至4台高階Mac Studio動輒數萬美元,加計折舊、電力與維護,目前僅限專業開發者與企業團隊,尚非普及型消費性AI PC。 - 商用授權限制:
Muse Spark Open採Muse Model License,附帶有限商業條款,並非完全無限制的開源軟體。 - 自主Agent資安風險:
當AI能自主讀寫文件、修改程式碼與執行系統指令時,企業必須建立嚴格的權限控管、沙盒與零信任機制。
威脅NVIDIA嗎?台積電(2330)與記憶體為何成實質贏家?
當AI推論開始從資料中心往桌面端遷移,各大硬體陣營與台灣供應鏈的受惠程度也出現明顯分化:

▲圖/Gemini
對台股而言,台積電(2330)是邏輯最清晰的受惠標的。
雖然Mac Studio單一產品出貨量遠小於iPhone或資料中心GPU,但當AI從「幾萬座資料中心」向「數億台終端工作站、AI PC、手機與車用晶片」滲透時,將全面推升CPU、GPU、NPU與高速I/O的先進製程需求,成為台積電長線AI成長曲線的另一隻腳。
AI算力從資料中心走向桌面
綜合來看,Apple與Meta聯手將8,160億參數模型搬上Mac Studio,代表AI產業正從「訓練與推論皆高度集中於資料中心」,演變為「訓練集中、但推論逐步往邊緣與桌面分散」的新格局——NVIDIA掌握資料中心、三大CSP掌握雲端、Meta卡位開放權重模型,而Apple則鎖定本地端AI硬體平台霸權。

▲圖/CMoney 蘋果(AAPL) K線圖

▲圖/CMoney META K線圖
本文內容僅供參考,無任何買賣建議,投資人應謹慎評估,風險自負。