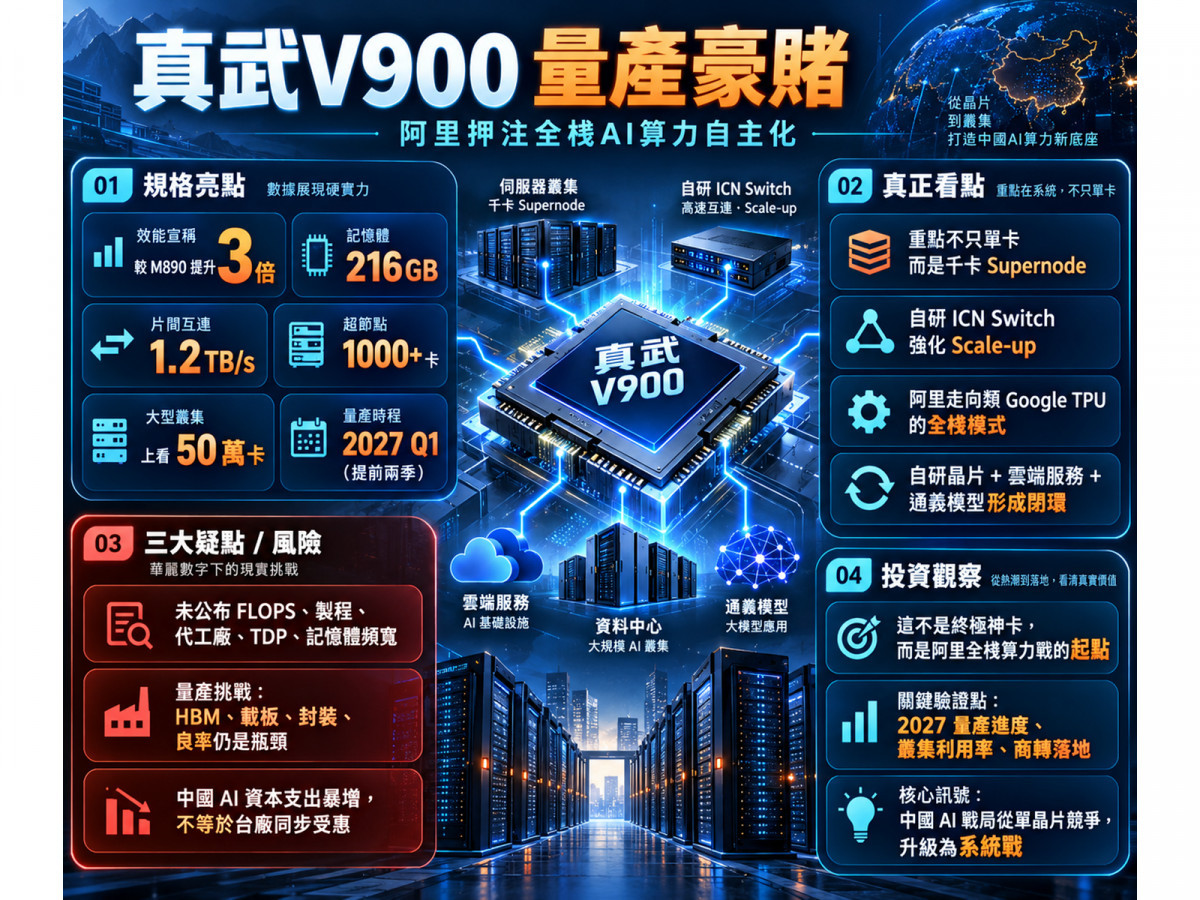
當看到一間科技巨頭宣布推出最新旗艦AI晶片,高調打出「效能是前代的3倍」、「記憶體飆上216GB」、片間頻寬高達「1,200GB/s」,甚至宣稱能串聯起「50萬張卡」的龐大叢集時,是否代表:中國自研算力終於能正面迎戰國際霸主了!
但如果我們把這張被吹捧為「中國最強AI晶片」的報告翻到背面,冷水恐怕會立刻澆下來。
今天,我們就用技術規格、供應鏈邏輯與財務數據,層層拆開平頭哥「真武V900」的真實底細。
狂歡與盲點:連FLOPS與功耗都沒公布的「中國最強」
先還原這場震撼業界的發表會。在9月22日的2026雲棲大會上,阿里巴巴正式發表平頭哥自研的「真武V900」,定位同時橫跨大模型訓練與推理。官方公布的升級規格看似十分亮眼:
- 記憶體容量:由今年5月發表的M890的144GB,大幅拉升50%至 216GB。
- 片間互連頻寬:由800GB/s提高50%至 1,200GB/s(1.2TB/s)。
- 低精度支援:正式補齊當前大模型主流的 FP8 與 FP4。
- 緊耦合架構:從原本磐久AL128超節點的128卡,一舉躍升到透過自研ICN Switch實現 超過1,000卡 的超大節點。
- 量產時程:最讓市場側目的是,今年5月產業路線圖原定在2027年第三季量產,如今直接宣布提前半年,拍板於 2027年第一季 量產商用。
量產時程硬生生提早兩季,反映的是阿里巴巴追趕中國算力缺口的極度焦慮。然而,這正是整則新聞第一個必須踩煞車的地方:「中國最強AI晶片」目前純粹是阿里巴巴的一家之言。
翻遍官方與外媒所有揭露資料,真武V900完全沒有公布最關鍵的FP8、FP4或BF16算力(FLOPS)、晶片製程、代工廠、功耗(TDP),以及對AI加速至關重要的「記憶體頻寬」!
在沒有任何第三方標準評測(Benchmark)的前提下,拋出一個孤立的「3倍效能」,根本無法推導出它能超越華為昇騰,甚至比肩輝達(NVIDIA)。衡量一顆AI晶片價值的是每瓦效能(Performance/Watt)、每美元效能(Performance/Dollar)與模型運算利用率(MFU),絕非PPT上一句籠統的宣傳詞。
市場有人拿V900的「216GB容量」去和華為昇騰960PR的「2.4TB/s頻寬」對比,這根本是不同維度的混淆。
若拉回同口徑的真實對比,華為端出的規格顯然具體得多:
- 片間互連頻寬:真武V900為 1.2TB/s,而華為昇騰960DT與960PR均達到 2.2TB/s。
- 記憶體規格:真武V900僅公布216GB容量、頻寬成謎;華為960DT則公布了288GB容量與高達 9.6TB/s 的記憶體頻寬,連2 PFLOPS(FP8)與4 PFLOPS(FP4)的算力都白紙黑字列出。
底牌翻得最少的人,卻喊得最大聲。這不是技術已定於一尊,而是公開資訊仍嚴重不足。
真正的戰略突圍:千卡Supernode與系統戰思維
那麼,V900難道只是一場文字遊戲嗎?也不盡然。這顆晶片真正具備產業戰略價值的地方,不在於單晶片有多強,而在於阿里對「Scale-up(縱向擴展)」架構的重構。
當前生成式AI模型正快速由2.4兆參數(如阿里旗艦Qwen3.8-Max),往5兆、甚至10兆參數(未來的Qwen 4.5與Qwen 5)狂奔。這種天文數字的模型,單顆晶片根本裝不下,必須把模型拆解到成千上萬顆處理器中。
這時系統的生死瓶頸不再是單卡算力,而是「通訊牆」。正如華為在技術大會上直言,在傳統十萬卡叢集中,處理器光是「彼此等資料」的通訊損耗就吃掉超過40%的訓練時間。
平頭哥透過自研ICN Switch,將緊耦合系統從128卡硬生生拉到1,000卡以上,讓千顆晶片共享記憶體語義溝通,這才是擊中要害的升級。
至於官方描繪的「50萬卡大型叢集」,投資人更得看懂門道:50萬卡不是一台插了50萬顆晶片的單一電腦,而是由千卡超節點透過資料中心網路串聯的橫向擴展叢集(Scale-out Cluster)。
堆疊晶片數量誰都會畫圖,但決定50萬卡是真神器還是廢鐵的,是模型算力利用率(MFU)。如果網路延遲與同步效率不彰,導致50萬卡只有30%的有效使用率,其產出算力甚至還不如一個調校優良、MFU達到60%的30萬卡叢集。2027年檢驗V900的真正考卷,不是插槽數量,而是大型叢集的實際算力折損率。
全棧閉環成形:阿里從「買晶片」走向「類Google TPU模式」
如果把眼光放寬到整個產業格局,這場發表會揭示的深層訊號是:中國AI算力版圖,正在從過去「晶片單點PK」,全面升級為兩大巨頭的「全棧系統戰」。
一邊是華為:以Ascend晶片為核心,整合UnifiedBus、HiZQ/HiBL記憶體、SuperPoD與光網路,正朝向串聯100萬顆處理器的生態狂奔。
另一邊則是阿里巴巴:以V900為箭頭,一口氣整合自研倚天(Yitian)CPU、ICN Switch交換晶片、盤邁(Panmai)SmartNIC智慧網卡、鎮岳(Zhenyue)SSD控制晶片,再掛載開源軟體棧T-Head SAIL(支援PyTorch、vLLM等框架)以及通義千問大模型,拼出了一整套完整的軟硬整合底座。
這正是輝達(NVIDIA)過去最堅固的護城河——CUDA與NVLink生態系。如今,阿里正試圖用一己之力在中國建立平行的自主體系。
而阿里手握的王牌,是比單純晶片設計廠強大得多的「自產自銷」商用生態:
- 商業落地驗證:截至今年4月,真武系列累計出貨已突破 56萬顆、服務逾400家客戶;最新財報揭露外部客戶已迅速擴大到 650家以上。這證明它不是實驗室樣品,而是具備商業出貨能力的成熟產品線。
- 自身龐大胃納:2026年6月季度,阿里雲外部收入年增45%,AI相關產品收入連續12個季度維持三位數爆炸成長,單季AI收入高達 123.76億元人民幣,雲端EBITA利潤率更改善至約12%。
阿里根本不需要到處求人買晶片,光是自身通義千問模型的龐大訓練、阿里雲的推論服務、電商推薦演算法與企業級AI Agent,就有源源不絕的算力胃納。這套「設計-內部消耗-雲端對外變現」的模式,本質上就是在複製Google TPU的成功路徑,其終極目的只有一個:藉由全棧自主硬體,徹底打掉對外採購的高昂溢價,大幅降低每個Token的生成成本。
擔心的三大死穴
講到這裡,故事似乎朝向中國算力完全自主的美好結局發展,但自研晶片規格畫得再漂亮、系統架構堆得再高,本質上都是「架構圖」。架構圖可以讓一檔股票在發表會隔日跳空大漲,但沒辦法憑空把實體晶片從無塵室裡變出來。
這場2027年的豪賭,眼前橫亙著三大難以迴避的致命灰犀牛:
1. 代工與先進製程成謎,切勿隨意連結台廠受惠
這是所有台股投資人最該劃清的防火線:阿里巴巴官方至今從未公布V900的晶圓代工廠、製程節點與封裝供應商!
市場上任何將真武V900直接套上「台積電(2330)將迎來爆發大單」的推論,目前完全缺乏公開證據支持。在嚴格的地緣政治與先進半導體出口管制下,是誰代工、良率多少、用什麼先進封裝,全都是未知數。投資分析切忌捕風捉影,絕不能將台積電(2330)視為V900的直接受惠者。
2. 產能天花板:不是沒有需求,而是「做不出來」
真武V900面臨的最大挑戰,很可能重演華為當前的困境。華為日前才公開坦承:AI設備產能甚至無法滿足中國國內需求,根本無力向海外擴張。
吳泳銘自己也承認,中長期算力需求遠大於阿里的供給能力,供應鏈短缺正實質限制阿里雲的擴張步伐。設計晶片只是跨過第一道檻,後面的高階記憶體(HBM)取得難題、載板缺料、封裝良率瓶頸,任何一個齒輪咬合不順,宣稱提早到2027年第一季的量產時程就可能面臨延宕。
3. 20GW的資本黑洞與台灣供應鏈的微妙處境
吳泳銘喊出2032年全球資料中心總容量要衝破 20GW,未來三年AI投資預計突破原定的 3,800億元人民幣。
這種天文數字意味著阿里巴巴將步入長期的「極限資本開支週期」。對投資人而言,這是一把鋒利的雙面刃:每帶來1塊錢的AI雲端營收,背後需要扛多少倍的龐大設備折舊?如果EBITA成長速度跑不贏折舊費用,現金流將面臨沉重考驗。
更耐人尋味的是,20GW的基建擴張固然帶動伺服器機櫃、電源、散熱與光通訊的需求,但當阿里與華為連CPU、GPU、網卡與儲存控制晶片都要「全面國產化」時,台灣伺服器供應鏈能分食到的BOM表價值,是否會被中國本土供應鏈逐步稀釋?「中國AI資本開支暴增」絕不等於「台廠訂單同比例狂飆」,這與美系四大雲端巨頭(CSP)高度依賴台廠的邏輯截然不同。
理周投研部表示:藏在發表會角落的「AI自我進化」彩蛋
最後,分享一個阿里在此次發表會中極具未來感、卻被多數財經版面忽略的技術細節:
在晶片研發實驗中,通義千問Qwen3.8-Max大模型在完全自主運行的情況下,持續工作超過60小時、自主調用晶片設計EDA工具逾10,000次,最終在不犧牲性能的前提下,竟將一個晶片匯流排模組的面積縮小了整整 42%!同時,該模型更在一個月內完成了33輪自動自我迭代,將評測分數推升。
這勾勒出一個驚人的閉環雛形:AI設計更好的晶片,更好的晶片訓練出更強的AI,再回頭設計下一代更強大的AI晶片。儘管這項實驗尚未有完整的同儕審查技術論文佐證,但它揭示了阿里巴巴正在嘗試的底層野心——晶片與模型的軟硬協同設計。
退去狂歡,緊盯2027量產真章
這場由真武V900掀起的算力旋風,最該避免的盲目結論,就是將其神化為「踢落輝達、一統江湖的終極神卡」。
它真正的歷史定位,是宣告了阿里巴巴不再滿足於只當一個向外採購算力的雲端平台,而是正式挺進包含晶片、互連、網通到模型的全棧基礎設施玩家,與華為共同分食原本屬於外商的中國市場TAM。
本文內容僅供參考,無任何買賣建議,投資人應謹慎評估,風險自負。